Wir messen AI Literacy falsch
Inhaltsverzeichnis zum Aufklappen
Die unterschätzte Fähigkeit: Urteilsfähigkeit
Selbstbild und tatsächliche Fähigkeiten
Wie Urteilsfähigkeit besser gemessen werden könnte
Fehler erkennen reicht trotzdem nicht
Was Unternehmen stattdessen messen sollten
Und wo bleibt das Lernen?
AI Literacy braucht kein perfektes Assessment
Und was Unternehmen stattdessen messen sollten
Generative AI liefert inzwischen Antworten auf Fragen, für deren Beurteilung häufig erhebliches Fachwissen erforderlich ist. Das gilt für medizinische Diagnosen ebenso wie für juristische Einschätzungen, wirtschaftliche Analysen oder technische Fragestellungen. Die Ergebnisse wirken oft überzeugend, selbst wenn sie Fehler enthalten. Wie schwierig es sein kann, solche Fehler zu erkennen, zeigt eine Untersuchung aus der medizinischen Ausbildung.
Ärztinnen und Ärzte in der Weiterbildung für Allgemeinmedizin bekamen medizinische Antworten von ChatGPT 4o vorgelegt. Ihre Aufgabe war es, korrekte Antworten von solchen mit Fehlern zu unterscheiden. Das gelang ihnen im Durchschnitt in nur 55 Prozent der Fälle. Besonders bemerkenswert: Die Hälfte der vorgelegten Antworten war korrekt, die andere Hälfte fehlerhaft. Die Trefferquote lag damit nur wenig über dem, was bei reinem Raten zu erwarten wäre. Das wirft eine Frage auf, die weit über die Medizin hinausgeht: Wie gut können wir beurteilen, ob ein überzeugend formulierter KI Output tatsächlich stimmt? [1]
Viele AI Literacy Assessments setzen andere Schwerpunkte. Sie prüfen Wissen über AI, Prompting, konkrete Tools, Datenschutz oder Governance. Unternehmen erfassen ausserdem, wie viele Mitarbeitende Trainings abgeschlossen haben oder wie intensiv bestimmte AI Tools genutzt werden. Diese Informationen sind durchaus wertvoll. Allerdings bleibt häufig offen, ob Mitarbeitende die Qualität der generierten Ergebnisse zuverlässig beurteilen können.
Wir messen viel, nur nicht unbedingt das Richtige
Der EU AI Act macht AI Literacy ausdrücklich zu einem Thema für Organisationen. Artikel 4 verlangt von Anbietern und Betreibern von AI Systemen, Massnahmen zu ergreifen, welche die Entwicklung entsprechender Kompetenzen ihrer Mitarbeitenden und anderer beteiligter Personen unterstützen. Dabei sollen unter anderem deren technisches Wissen, Erfahrung, Ausbildung sowie der konkrete Einsatzkontext berücksichtigt werden. [2]
Inzwischen gibt es in vielen Unternehmen Kompetenz-Assessments, Skill-Matrizen, Reifegradmodelle und Learning-Journeys. Das halte ich grundsätzlich für richtig. Wer AI-Adoption gezielt entwickeln will, sollte wissen, wo die Organisation steht und welche Wirkung die eigenen Entwicklungsaktivitäten entfalten.
Schwierig wird es, wenn wir unterschiedliche Messgrössen gleichsetzen. Eine hohe Trainingsquote sagt zunächst etwas über die Teilnahme aus. Eine Lizenzquote zeigt, wie weit der Zugang zu bestimmten Tools verbreitet ist. Und wenn Mitarbeitende angeben, dass sie AI-Ergebnisse gut beurteilen können, wissen wir vor allem, wie sie ihre eigenen Fähigkeiten einschätzen. Ob sie tatsächlich kompetent handeln, bleibt damit weitgehend ungeklärt.
Die unterschätzte Fähigkeit: Urteilsfähigkeit
Klassische Assessments konzentrieren sich häufig auf Grundlagenwissen, Prompting, Toolwissen sowie Fragen zu Ethik, Datenschutz und Governance. Im Arbeitsalltag kommt eine weitere Fähigkeit hinzu, die aus meiner Sicht mehr Aufmerksamkeit verdient: Mitarbeitende müssen erkennen können, wann ein plausibel klingender AI Output falsch, unvollständig oder problematisch ist.
Ich nenne das hier Urteilsfähigkeit. Gemeint ist die Fähigkeit, die Qualität eines generierten Ergebnisses angemessen einzuschätzen, richtige von fehlerhaften Aussagen zu unterscheiden und die eigene Sicherheit dabei möglichst realistisch zu beurteilen.
Gerade generative AI macht es uns dabei nicht leicht. Ein schlechter Output kann sprachlich hervorragend wirken, ein falsches Argument plausibel klingen und eine erfundene Quelle aussehen wie eine echte. Wer einen guten Prompt formulieren kann, ist deshalb noch lange nicht in der Lage, die Qualität des Ergebnisses zuverlässig zu bewerten.
Selbstbild und tatsächliche Fähigkeiten
Wie schwierig eine aussagekräftige Messung ist, zeigt ein systematischer Review von Tomáš Lintner. Er untersuchte 16 wissenschaftlich entwickelte Skalen zur Messung von AI Literacy. Nur drei davon waren leistungsbasiert, dreizehn stützten sich auf Selbstauskünfte. Hinzu kommt, dass wichtige Messeigenschaften vieler Skalen bisher nur begrenzt untersucht wurden. Keine der analysierten Skalen war beispielsweise auf kulturübergreifende Validität oder Messfehler geprüft worden. [3]
Self-Assessments haben durchaus ihre Berechtigung. Möchte ich wissen, wie sicher sich Mitarbeitende im Umgang mit AI fühlen, liefert mir eine Selbsteinschätzung interessante Informationen. Für die Beurteilung tatsächlicher Fähigkeiten brauche ich allerdings andere Methoden, bspw. konkrete Leistungsaufgaben.
Wie weit Selbstbild und tatsächliche Fähigkeit auseinanderliegen können, zeigt auch eine Studie von Kit Double. Untersucht wurde das sogenannte metakognitive Monitoring, vereinfacht gesagt die Fähigkeit, die Qualität des eigenen Urteils einzuschätzen. Die Teilnehmenden bewerteten zunächst ihre eigene Monitoringfähigkeit. Anschliessend wurde diese anhand konkreter Aufgaben und Konfidenzurteile gemessen.
Bei mehreren der verwendeten objektiven Masse zeigte sich sogar ein negativer Zusammenhang zwischen wahrgenommener und tatsächlich gemessener Monitoringfähigkeit. Andere Masse zeigten keinen entsprechenden Zusammenhang. Die Ergebnisse machen deutlich, wie vorsichtig wir Selbstauskünfte interpretieren sollten. Wer sich für kompetent hält, muss es deshalb noch lange nicht sein. [4]
Wie Urteilsfähigkeit besser gemessen werden könnte
Eine pragmatische Messung könnte mit konkreten Aufgaben arbeiten. Mitarbeitende erhalten beispielsweise mehrere AI Outputs, von denen einige korrekt sind und andere Fehler enthalten. Nach jedem Ergebnis entscheiden sie, ob sie diesem vertrauen würden, und geben zusätzlich an, wie sicher sie sich bei ihrem Urteil sind. So lässt sich beobachten, wie zuverlässig eine Person Fehler erkennt und wie gut ihre subjektive Sicherheit mit der tatsächlichen Trefferquote übereinstimmt.
Stellen wir uns zwei Personen vor, die bei zehn Aufgaben jeweils achtmal richtig liegen. Auf den ersten Blick verfügen beide über vergleichbare Fähigkeiten. Allerdings ist die erste Person gerade bei ihren falschen Antworten eher unsicher, während die zweite ihre Fehlurteile mit grosser Überzeugung vertritt. Im Arbeitsalltag kann dieser Unterschied erhebliche Folgen haben, weil Menschen, die die Grenzen des eigenen Urteils erkennen, im Zweifelsfall eher zusätzliche Informationen einholen oder ein Ergebnis überprüfen könnten.
Fehler erkennen reicht trotzdem nicht
Markus Langer, Kevin Baum und Nadine Schlicker schlagen vor, menschliche Aufsicht über AI mithilfe der Signal Detection Theory zu betrachten. Dabei unterscheiden sie unter anderem zwischen der Sensitivität, also der Fähigkeit, fehlerhafte von korrekten Outputs zu unterscheiden, und dem Response Bias. Letzterer beschreibt, wie viel Evidenz jemand benötigt, bevor ein Output als problematisch eingestuft wird. [5]
Was bedeutet das für die Praxis? Stellen Sie sich zwei Mitarbeitende vor, die einen verdächtigen AI Output sehen. Beide besitzen grundsätzlich genug Fachwissen, um den Fehler zu erkennen. Person A überprüft das Ergebnis, korrigiert es und verwendet den Output erst danach. Person B denkt sich: „Wird schon stimmen“, und übernimmt ihn.
In einem klassischen Kompetenztest könnten beide gleich abschneiden. Bei der tatsächlichen Arbeit entstehen jedoch unterschiedliche Ergebnisse. Kompetenz allein garantiert noch keine Performanz. Wenn wir verstehen wollen, wie gut Menschen mit KI arbeiten, müssen wir deshalb auch ihr Verhalten betrachten.
Was Unternehmen stattdessen messen sollten
Aus meiner Sicht brauchen wir mindestens drei Perspektiven, um den kompetenten Umgang mit AI in einer Organisation angemessen zu beurteilen:
1. Capability: Können Menschen es?
Die erste Ebene betrifft die tatsächlichen Fähigkeiten. Verstehen Mitarbeitende grundlegende Funktionsweisen und Grenzen von AI? Können sie geeignete Anwendungsfälle erkennen, generierte Ergebnisse fachlich prüfen und Fehler identifizieren? Wissen sie, wann zusätzliche Kontrolle notwendig ist?
Leistungsbasierte Assessments können hier wertvolle Erkenntnisse liefern. Anstelle einer allgemeinen Frage wie „Wie gut kannst du KI Ergebnisse beurteilen?“ könnten Mitarbeitende konkrete Aufgaben bearbeiten: „Hier ist ein KI Ergebnis. Welche Aussagen sind korrekt, wo liegen mögliche Fehler und wie sicher bist du dir bei deiner Einschätzung?“ Gerade für die Beurteilung der Urteilsfähigkeit halte ich solche Aufgaben für aussagekräftiger als reine Selbsteinschätzungen.
2. Behaviour: Tun Menschen es auch?
Die zweite Ebene richtet den Blick auf das tatsächliche Verhalten. Mitarbeitende können durchaus wissen, dass sie ein AI Ergebnis überprüfen sollten. Ob sie sich unter Zeitdruck auch daran halten, ist eine andere Frage.
Für Unternehmen ist deshalb interessant, wie AI im Arbeitsalltag eingesetzt wird. Werden generierte Ergebnisse überprüft? Sichern Mitarbeitende wichtige Entscheidungen durch zusätzliche Quellen ab? Werden erkannte Fehler korrigiert, bevor Informationen weitergegeben werden? Welche Auswirkungen hat der Einsatz von AI auf die Qualität der Arbeit?
Je nach Kontext können Qualitätsaudits, Arbeitsproben, Prozessdaten, Peer-Feedback oder Team-Befragungen helfen, diese Fragen zu beantworten. Die Unterscheidung zwischen Fähigkeit und Verhalten ist entscheidend, schliesslich möchten wir wissen, ob vorhandene Kompetenzen im Arbeitsalltag tatsächlich zur Anwendung kommen.
3. System: Ermöglicht die Organisation gutes Verhalten?
Mit der dritten Ebene rückt die Organisation selbst in den Mittelpunkt. Mitarbeitende handeln schliesslich innerhalb bestimmter Strukturen, Erwartungen und Rahmenbedingungen.
Vielleicht wissen sie genau, dass ein AI Ergebnis überprüft werden sollte. Wenn gleichzeitig jede zusätzliche Minute Kontrolle als Ineffizienz gilt, wird dieses Verhalten trotzdem unwahrscheinlicher. Vielleicht möchten Teams mit AI experimentieren, werden aber durch eine Fehlerkultur ausgebremst, in der jeder Irrtum sanktioniert wird. Oder Führungskräfte erwarten eine schnelle Adoption, schaffen aber kaum Freiräume, um neue Arbeitsweisen zu erproben.
In solchen Situationen lohnt sich ein genauerer Blick auf die organisatorischen Bedingungen. Bekommen Mitarbeitende ausreichend Zeit zum Lernen und Experimentieren? Sind Qualitätsstandards für AI gestützte Arbeit klar definiert? Welche Verhaltensweisen werden durch formelle und informelle Anreize gefördert? Können Teams offen über Fehler und schlechte Ergebnisse sprechen? Und verfügen Führungskräfte über die notwendigen Werkzeuge, um die Entwicklung neuer Arbeitsweisen zu unterstützen?
Interviews, Fokusgruppen, Audits und Organisationsbefragungen können helfen, solche Zusammenhänge sichtbar zu machen.
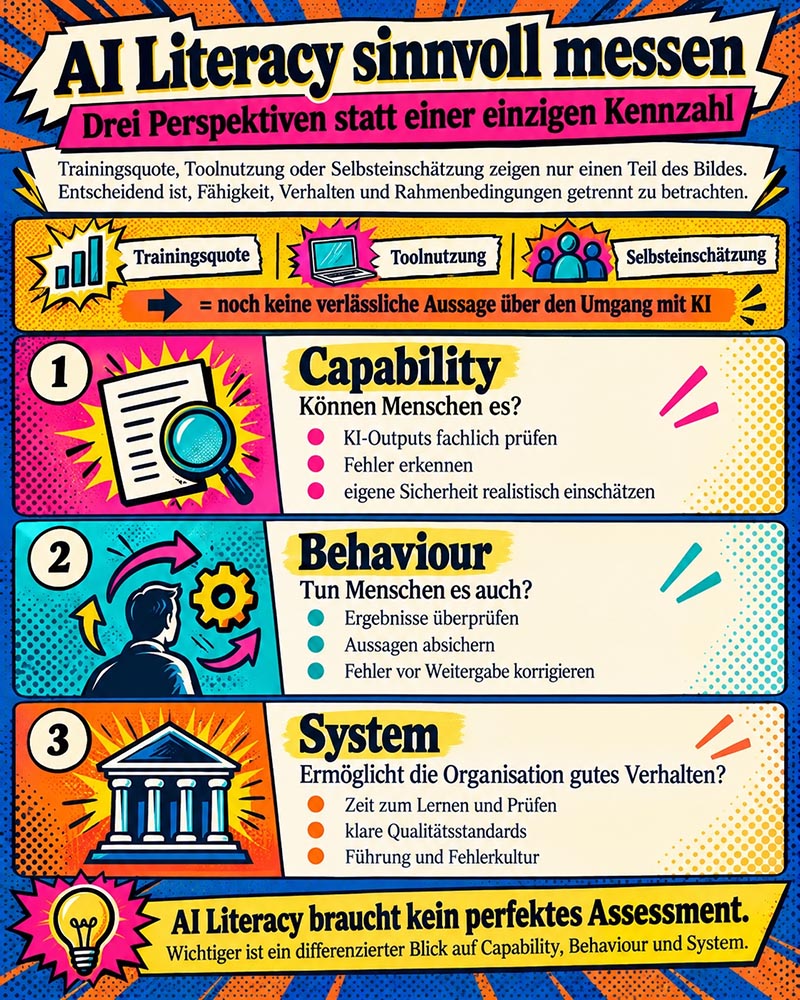
Abbildung: AI Literacy sinnvoll messen
Und wo bleibt das Lernen?
Lernen lässt sich in diesem Modell über die Veränderung im Zeitverlauf betrachten. Wir können beobachten, ob Mitarbeitende problematische AI Outputs zuverlässiger erkennen, ihr Verhalten anpassen und ob sich innerhalb der Organisation bessere Routinen entwickeln.
Vorher-Nachher-Messungen sind dafür besonders interessant. Eine Organisation muss nicht zwingend wissen, ob ihre durchschnittliche AI Literacy heute bei 63 oder 67 Punkten liegt. Wesentlich hilfreicher könnte die Frage sein: Werden wir besser? Wenn Mitarbeitende nach einer Lernintervention Fehler zuverlässiger erkennen, ihre eigene Sicherheit realistischer einschätzen und generierte Ergebnisse im Alltag sorgfältiger überprüfen, wird eine relevante Entwicklung sichtbar.
Trainingsfeedback und Selbsteinschätzungen können diesen Blick ergänzen. Auch Teilnahmequoten und Nutzungsdaten liefern Informationen. Wichtig ist allerdings, die Aussagekraft der einzelnen Kennzahlen richtig einzuordnen. Kursquoten erfassen die Teilnahme an Lernangeboten. Lizenzquoten geben Auskunft über den Zugang zu Tools. Selbsteinschätzungen zeigen die subjektive Wahrnehmung, Leistungsaufgaben bestimmte Fähigkeiten und Verhaltensdaten deren Anwendung. Organisationsdiagnostik wiederum hilft, förderliche und hinderliche Rahmenbedingungen zu erkennen.
Jede dieser Messgrössen beleuchtet einen anderen Ausschnitt. Erst ihre sinnvolle Kombination ermöglicht eine differenzierte Betrachtung.
AI Literacy braucht kein perfektes Assessment
Aktuell gibt es kein einzelnes, wissenschaftlich umfassend abgesichertes und gleichzeitig pragmatisch einsetzbares Assessment, das AI Literacy im Unternehmenskontext vollständig erfasst. Lintners Review verdeutlicht sowohl die Vielfalt der vorhandenen Instrumente als auch die Lücken in ihrer bisherigen Validierung.
Vielleicht ist die Suche nach dem einen perfekten Assessment ohnehin der falsche Ansatz. Unternehmen könnten deutlich mehr gewinnen, wenn sie verschiedene Fragen gezielt und mit geeigneten Methoden beantworten:
- Können unsere Mitarbeitenden kompetent mit KI umgehen?
- Wenden sie diese Fähigkeiten im Arbeitsalltag an?
- Und schaffen wir als Organisation die Voraussetzungen dafür, dass gutes Verhalten wahrscheinlich wird?
Capability, Behaviour und System. Wer diese drei Ebenen auseinanderhält und ihre Entwicklung über die Zeit beobachtet, erhält ein differenzierteres Bild als mit der nächsten AI-Literacy-Ampel. Vielleicht sollten wir uns deshalb weniger mit der Frage beschäftigen, welchen Kompetenzwert eine Organisation erreicht, und mehr damit, was ihre Mitarbeitenden tatsächlich können, wie sie handeln und welche Bedingungen sie dabei unterstützen.
Hinweise:
Interessieren Sie sich für weitere Perspektiven von Dr. Joël Krapf auf Künstliche Intelligenz in der Arbeitswelt? Dann lohnt sich definitiv ein Blick auf Proof2Practice.
[1] Zhou, J. et al. (2025): Integrating AI into clinical education: evaluating general practice trainees’ proficiency in distinguishing AI-generated hallucinations and impacting factors. BMC Medical Education.
[2] Europäische Union: Artificial Intelligence Act, Artikel 4.
[3] Lintner, T. (2024): A systematic review of AI literacy scales. npj Science of Learning.
[4] Double, K. S. (2025): Survey measures of metacognitive monitoring are often false. Behavior Research Methods.
[5] Langer, M., Baum, K. & Schlicker, N. (2025): Effective Human Oversight of AI-Based Systems: A Signal Detection Perspective on the Detection of Inaccurate and Unfair Outputs. Minds and Machines.
Wollen Sie Dr. Joël Krapf unterstützen und über AI Literacy diskutieren? Dann teilen Sie diesen Beitrag auf Social Media oder in Ihrem Unternehmen.
Dr. Joël Krapf hat drei weitere Beiträge im t2informatik Blog veröffentlicht:

Herausforderungen bei stagnierenden Transformationen meistern

Agilität war erst der Anfang

Agile ist kein Mindset

Dr. Joël Krapf
Wie können Menschen & Organisationen in einem Zeitalter schnellen technologischen Wandels erfolgreich sein? Diese Frage verfolgt Dr. Joël Krapf seit 15 Jahren in unterschiedlichen Rollen: als Führungskraft, als Berater, als organisationsinterner Transformationsverantwortlicher und heute als Professor für KI in der Arbeitswelt am Institut für New Work der Berner Fachhochschule.
In seiner Arbeit untersucht er, was Organisationen im KI-Zeitalter tatsächlich weiterbringt, und bringt die Ergebnisse zurück in die Praxis. Sein Anspruch: belastbare Evidenz statt Buzzwords, übersetzt in Entscheidungen, die im Organisationsalltag Wirkung entfalten.
Im t2informatik Blog teilen wir Wissen und Erfahrungen mit Menschen in Organisationen. Und für genau diese Menschen entwickeln und modernisieren wir seit 2012 Software. Pragmatisch. ✔️ Persönlich. ✔️ Professionell. ✔️ Lernen Sie t2informatik als Entwicklungspartner kennen.