Wie fachliche Entscheidungen unbemerkt im Code landen
Ein Pull Request, zwei geänderte Zeilen. Ein Schwellenwert wandert von 0,72 auf 0,65. Der Kommentar dazu lautet „zu wenig Kandidaten im Funnel”. Das Review dauert vier Minuten, gemerged wird am selben Nachmittag.
Niemand in diesem Vorgang hätte auf die Frage, ob er gerade eine Entscheidung über Menschen getroffen hat, mit Ja geantwortet. Und trotzdem bestimmt diese Zahl ab dem nächsten Deployment, wessen Bewerbung ein Mensch überhaupt zu sehen bekommt.
In meinem letzten Beitrag hier im Blog ging es um die Frage, wer in einer Organisation entscheiden darf: die KI, ein Mensch mit ihrer Unterstützung oder ein Mensch ohne sie. Vier Zonen, sortiert nach der Tragweite der Entscheidung. Dieser Beitrag beschreibt die Etage darunter, denn die Zonen-Zuordnung, die in einem Workshop entsteht, hält oder bricht an einer Stelle, die in keinem Workshop vorkommt: im Repository.
Die Anforderung schweigt genau dort, wo es zählt
Eine Anforderung sagt: „Eingehende Bewerbungen werden nach definierten Kriterien vorsortiert.” Ein sauberer Satz, fachlich abgenommen, im Sprint eingeplant.
Was der Satz nicht sagt: bei welchem Score die Sortierung endet und ob unterhalb der Schwelle noch jemand hinsieht. Ebenso offen bleibt, wie mit Lücken im Lebenslauf umgegangen wird und auf welcher Grundlage das Modell lernt: aus den Einstellungen der vergangenen zehn Jahre oder aus einem definierten Anforderungsprofil.
Diese Lücken sind nicht zwangsläufig Nachlässigkeit. Sie entstehen, weil die Fachseite die Frage in dieser Auflösung häufig gar nicht stellt und die Entwicklung trotzdem eine konkrete Antwort braucht. Ohne einen Wert, eine Gewichtung oder einen Default läuft kein Code.
Was fachlich unentschieden bleibt, wird technisch entschieden.
Genau an dieser Nahtstelle entsteht ein Entscheidungsraum, für den Organisationen häufig keine Rolle vorgesehen haben. Der Fachbereich glaubt, entschieden zu haben, weil er die Anforderung abgenommen hat. Die Entwicklung versteht sich als umsetzend, weil sie einer freigegebenen Anforderung folgt. Beides ist nachvollziehbar. Und trotzdem kann am Ende eine Festlegung entstehen, die erhebliche Wirkung entfaltet, ohne dass jemand sie bewusst als fachliche Entscheidung getroffen hat.
Das Problem besteht deshalb nicht darin, dass Entwicklerinnen und Entwickler heimlich Fachentscheidungen an sich ziehen. Das Problem besteht darin, dass Organisationen manche Entscheidungen erst dann erkennen, wenn sie bereits im Code stehen.
Drei Stellen, an denen das regelmäßig passiert
Besonders häufig entstehen solche unbeabsichtigten Fachentscheidungen dort, wo technische Details konkrete Wirkung auf spätere Einzelfälle entfalten.
1. Schwellen und Grenzwerte
Jede Automatisierung braucht eine Kante: ab welchem Betrag ein Vorgang zur Freigabe geht, ab welchem Score eine Anfrage automatisch beantwortet wird oder ab welcher Konfidenz das System selbst handelt.
Eine solche Zahl kann darüber entscheiden, ob ein Vorgang automatisiert bearbeitet wird oder ein Mensch beteiligt bleibt.
Wie schwer eine scheinbar technische Schwelle wiegen kann, zeigte die Vergabe der englischen A-Level-Noten im Sommer 2020. Weil die Prüfungen ausfielen, wurden Lehrerprognosen durch ein von der Prüfungsaufsicht Ofqual entwickeltes Verfahren standardisiert. Dabei spielte unter anderem die Größe eines Kurses eine Rolle: Bei weniger als fünf Kandidatinnen und Kandidaten blieb die Einschätzung der Lehrkraft unverändert, bei fünf bis 15 wurde sie mit dem berechneten Ergebnis gewichtet.[1] Eine numerische Grenze beeinflusste damit, wann menschliches Urteil bestehen blieb und wann die Berechnung stärker eingriff.
Die eigentliche Lehre daraus ist weniger die konkrete Zahl als ihr Charakter: Eine Grenze, die technisch aussieht, kann gesellschaftliche oder organisatorische Wirkung entfalten.
2. Die Auswahl dessen, was überhaupt gemessen wird
Auch die Entscheidung darüber, welche Daten und Merkmale in ein System eingehen, wirkt auf das Ergebnis.
Amazon entwickelte ein Recruiting-Werkzeug, das Bewerberinnen systematisch benachteiligte und schließlich aufgegeben wurde. Das System hatte aus Bewerbungen der zurückliegenden zehn Jahre gelernt, die überwiegend von Männern stammten.[2] Die Wahl dieser Datenbasis war technisch plausibel, aber keineswegs neutral: Wer aus vergangenen Entscheidungen lernt, übernimmt möglicherweise auch deren Muster.
Die Wertentscheidung steckt dann nicht in einer ausdrücklich formulierten Regel. Sie steckt in der Auswahl dessen, was dem System als relevante Vergangenheit gezeigt wird.
3. Defaults und Eskalationspfade
Was passiert, wenn das System unsicher ist? Läuft der Vorgang weiter, hält er an oder landet er bei einem Menschen? Und wenn ja, bei welchem?
Ein Default beantwortet eine Frage für alle Fälle, in denen niemand aktiv eingreift. Gerade deshalb verdienen solche Festlegungen mehr Aufmerksamkeit, als ihre technische Unauffälligkeit vermuten lässt.
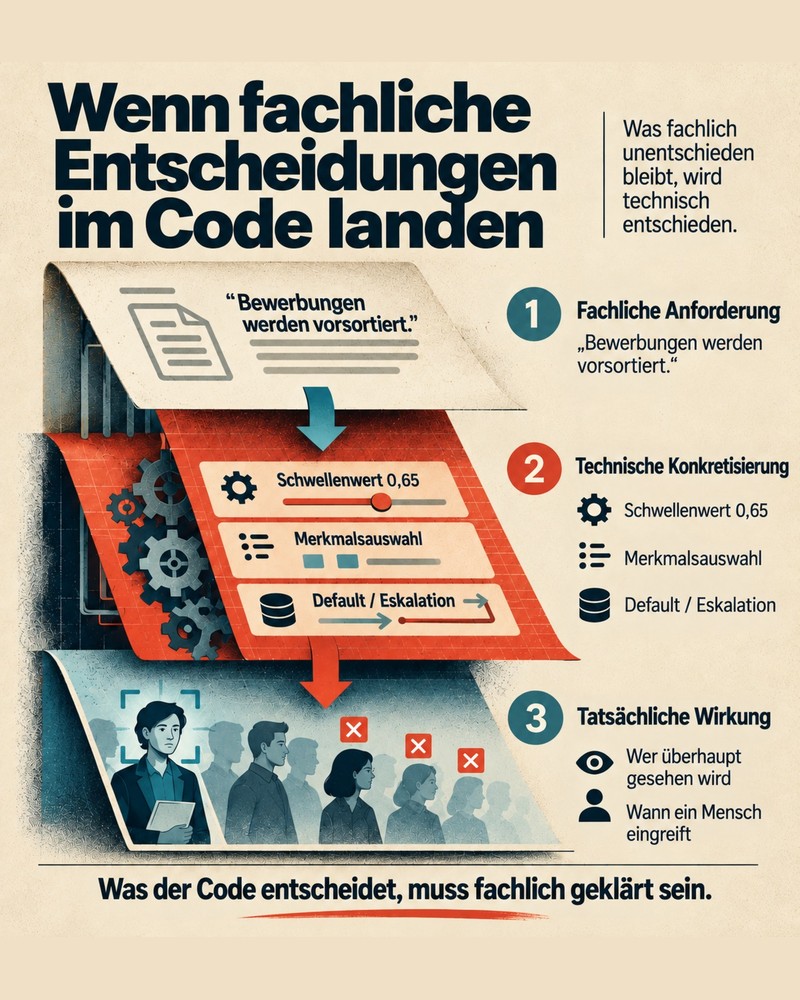
Abbildung: Von der Anforderung zur tatsächlichen Wirkung
„Nur vorbereitend” ist keine sichere Antwort
An dieser Stelle kommt in Diskussionen regelmäßig das Argument, das System entscheide ja gar nicht, es bereite lediglich vor. Ein Mensch schaue schließlich noch einmal darauf.
Der Europäische Gerichtshof hat dieser Sichtweise 2023 im SCHUFA-Verfahren eine wichtige Grenze gezogen. Die automatisierte Ermittlung eines Bonitätsscores kann selbst als automatisierte Entscheidung im Sinne der DSGVO gelten, wenn ein Dritter, etwa eine Bank, diesen Wert maßgeblich für seine Entscheidung heranzieht.[3]
Entscheidend ist damit nicht allein, wer formal den letzten Schritt ausführt, sondern welche tatsächliche Wirkung eine automatisiert erzeugte Bewertung entfaltet. Für Organisationen ist das mehr als eine juristische Randnotiz.
Ein Mensch im Prozess wird nicht schon dadurch zu einer wirksamen Prüfinstanz, dass er einen Vorgang angezeigt bekommt oder einen Button anklickt. Er muss verstehen, worauf die Empfehlung beruht, sie prüfen können und realistisch die Möglichkeit haben, von ihr abzuweichen.
Deshalb ist die Abweichungsquote interessant. Nicht weil eine niedrige Quote automatisch beweist, dass keine Prüfung stattfindet. Ein gutes System kann schließlich häufig richtige Vorschläge machen. Aber eine nahezu vollständige Übereinstimmung über lange Zeit sollte zumindest eine Frage auslösen: Prüft hier tatsächlich jemand eigenständig oder bestätigt der Prozess nur routinemäßig eine maschinelle Vorentscheidung?
Die entscheidende Frage lautet deshalb nicht allein, ob ein Mensch beteiligt ist. Sie lautet: Kann dieser Mensch wirklich anders entscheiden und tut er es gelegentlich auch?
Die Verantwortung wandert flussaufwärts
Wenn eine Entscheidung im Code steckt, verschwindet sie nicht. Sie verlagert sich zu denen, die Schwellenwerte gesetzt, Daten ausgewählt, Modelle konfiguriert, Vorlagen geschrieben oder Anbieter ausgewählt haben.
Besonders deutlich wird das beim Modellwechsel. Ihr Anbieter kündigt die Version ab, die Sie vor einem Jahr geprüft und freigegeben haben. Der Nachfolger gewichtet anders, sperrt andere Inhalte und verhält sich in Grenzfällen vorsichtiger oder forscher als sein Vorgänger.
Im Backlog steht dazu ein Ticket mit dem Titel „Modellversion aktualisieren”, eingeplant als Wartung und geschätzt auf zwei Tage. Niemand in Ihrem Haus hat beschlossen, dass sich die Grenze zwischen zwei Entscheidungskategorien verschieben soll. Verschoben haben kann sie sich trotzdem. Die ursprüngliche Freigabe gilt formal weiter, obwohl sich das Verhalten des Systems verändert hat.
Das ist eine unbequeme Eigenschaft von Automatisierung: Verantwortung verlagert sich nach vorne im Prozess und damit häufig an Stellen, die sich selbst nicht als Entscheidungspunkte verstehen. Ein Team, das eine Prompt-Vorlage verändert, beeinflusst möglicherweise Tausende spätere Einzelfälle. Eine Einkaufsabteilung, die zwischen zwei Anbietern wählt, entscheidet indirekt auch über Modelleigenschaften, Trainingsgrundlagen, Sperrmechanismen und Ausweichverhalten.
Diese Verlagerung lässt sich kaum vermeiden. Unsichtbar bleiben muss sie deshalb nicht.
Was in der Praxis hilft
Die gute Nachricht ist: Entwicklungsorganisationen brauchen dafür nicht zwangsläufig ein neues Governance-System. Viele der notwendigen Werkzeuge existieren bereits. Sie müssen lediglich auf Entscheidungen angewendet werden, die bisher häufig als rein technische Umsetzung gelten.
Die Abweichungsquote beobachten
Wenn ein Mensch als Prüfinstanz vorgesehen ist, sollte sichtbar sein, wie häufig maschinelle Empfehlungen bestätigt, verändert oder verworfen werden. Eine sehr niedrige Abweichungsquote ist noch kein Beweis für einen wirkungslosen Review. Sie ist aber ein guter Anlass, genauer hinzusehen: Kennt die prüfende Person die Entscheidungsgrundlage? Hat sie ausreichend Informationen? Gibt es Zeit und Anreiz, tatsächlich zu prüfen? Und was geschieht, wenn sie widerspricht?
Die Kennzahl ersetzt also nicht die qualitative Prüfung des Prozesses. Sie zeigt, wo sie sich lohnt.
Entscheidungsverantwortung im Ticket sichtbar machen
Jede Story, die maschinelle Vorentscheidungen berührt, erhält eine Einordnung in die jeweilige Entscheidungszone. Bei relevanten Zonen wird zusätzlich festgehalten, welche fachliche Rolle die Verantwortung trägt und welche konkrete Person diese Verantwortung aktuell wahrnimmt.
Beides ist wichtig. Nur eine Rolle bleibt leicht abstrakt. Nur ein Name verschwindet mit dem nächsten Stellenwechsel. Wenn sich beim Ausfüllen herausstellt, dass weder eine zuständige Rolle noch eine verantwortliche Person benannt werden kann, ist bereits etwas Wesentliches sichtbar geworden.
Entscheidungen dort dokumentieren, wo sie fallen
Architecture Decision Records sind in vielen Teams etabliert: kurze Notizen zu Kontext, Alternativen, Entscheidung und Konsequenzen. Der Auslöser dafür lässt sich erweitern. Wer einen Schwellenwert setzt, der erhebliche Wirkung auf Menschen hat, eine Datenbasis auswählt oder einen Eskalationspfad definiert, dokumentiert nicht nur die technische Umsetzung, sondern auch die fachliche Begründung.
Dafür braucht es kein zwanzigseitiges Governance-Dokument. Oft reichen wenige Zeilen. Der Wert entsteht später, wenn jemand nachvollziehen kann, warum eine Zahl gewählt wurde, welche Alternativen diskutiert wurden und wer die Entscheidung getragen hat.
Eine Review-Regel mit Zähnen
Änderungen an relevanten Schwellen, Merkmalslisten, Prompt-Vorlagen oder Eskalationsregeln sollten nicht ausschließlich technisch reviewed werden. Sie brauchen ein zweites Augenpaar aus dem fachlich verantwortlichen Bereich.
Das kostet etwas Durchlaufzeit. Dafür verhindert es genau jene Änderungen, die technisch banal aussehen und fachlich weitreichend wirken.
Keines dieser Mittel ist besonders spektakulär. Das müssen sie auch nicht sein. Entscheidend ist, dass Organisationen technische Konkretisierungen dort als Entscheidungen behandeln, wo sie tatsächlich Entscheidungswirkung entfalten.
Entscheidungen bis in den Code klären
Die Zonen-Zuordnung aus dem Workshop und die Zahl im Config-File müssen dieselbe Antwort geben. Sonst haben Sie zwei Systeme: eines, das beschreibt, wie entschieden werden soll, und eines, das tatsächlich entscheidet.
Der Test dafür ist unspektakulär. Nehmen Sie einen Ihrer automatisierten Prozesse und fragen Sie, wer den Schwellenwert gewählt hat, der ihn steuert. Fragen Sie anschließend, warum genau dieser Wert gilt und wer fachlich dafür einsteht.
Kommt darauf eine nachvollziehbare Antwort, ist die Klärung bis in die technische Umsetzung vorgedrungen. Kommt ein Achselzucken, haben Sie eine Entscheidung gefunden, die Ihre Organisation bislang nicht als solche behandelt hat.
Nicht jede technische Entscheidung ist eine fachliche Entscheidung, aber manche technische Festlegung wird zur fachlichen Entscheidung, weil vorher niemand entschieden hat.
Hinweise:
Guido Bosbach unterstützt Organistationen auf ihrem Weg zu Klarheit im Miteinander. Gerne tauscht er sich mit Ihnen über die konkrete Klärung von Verantwortung in Ihrem Unternehmen aus. Kontaktieren Sie ihn einfach über seine Website oder schreiben Sie ihn auf LinkedIn an.
Sehr zu empfehlen ist zudem sein workLIFE Stories Blog, in dem er regelmäßig Erfahrungen aus Unternehmen, Ideen und Impulse anbietet.
[1] Ofqual: Grading gaps in summer 2020: who was affected by differences between centre assessment grades and calculated grades?
[2] Reuters: Amazon scraps secret AI recruiting tool that showed bias against women
[3] Gerichtshof der Europäischen Union: Urteil im SCHUFA-Verfahren C-634/21 vom 7. Dezember 2023
Wollen Sie Guido Bosbach unterstützen und über Entscheidung und Verantwortung diskutieren? Dann teilen Sie diesen Beitrag auf Social Media oder in Ihrem Unternehmen.
Guido Bosbach hat zwei weitere Beiträge im t2informatik Blog veröffentlicht:
Ethik ist keine Rolle, die man besetzen kann
KI braucht Klarheit
Guido Bosbach
Guido Bosbach berät Geschäftsführungen und Führungsteams dabei, Klarheit über Verantwortung, Entscheidungswege und Werte in ihrer Organisation zu gewinnen – bevor daraus ungeklärte Konflikte werden. Er begleitet Unternehmen von der ersten Bestandsaufnahme bis zum gelebten Review-Rhythmus, aktuell mit einem Schwerpunkt auf der Frage, wie Organisationen Verantwortung für KI-Entscheidungen klären, ohne sie dauerhaft auszulagern.
Im t2informatik Blog teilen wir Wissen und Erfahrungen mit Menschen in Organisationen. Und für genau diese Menschen entwickeln und modernisieren wir seit 2012 Software. Pragmatisch. ✔️ Persönlich. ✔️ Professionell. ✔️ Lernen Sie t2informatik als Entwicklungspartner kennen.